从 Qwen-VL 到 Qwen3-VL:多模态大模型的四代进化之路
Published:
Tags: Multimodal, Qwen, VLM
TL;DR: 本文系统梳理了 Qwen-VL 系列四代模型的技术演进:从初代 Qwen-VL 建立了视觉-语言对齐和三阶段训练流程;到 Qwen2-VL 引入动态分辨率、M-RoPE 和视频输入;再到 Qwen2.5-VL 主要补推理效率、视频时间建模和后训练数据质量;最终走向更深层的视觉-语言融合(Qwen3-VL)。
多模态大模型(Multimodal Large Language Models, MLLMs)是 AI 领域最活跃的研究方向之一。在众多视觉语言模型中,Qwen-VL 系列不只是因为其开源模型屠榜各大 benchmark,更以其清晰的迭代路径和扎实的工程设计备受关注。从 2023 年初代 Qwen-VL 的发布到 2025 年 Qwen3-VL 的亮相,四代模型在架构设计、位置编码方案和训练策略上展现出一条连贯且富有洞见的演进主线。
本文将逐一解析每代模型。全文结构如下:
| 章节 | 模型 | 关键词 |
|---|---|---|
| Part I | Qwen-VL (2023) | 三阶段渐进训练、视觉-语言对齐、多任务统一 |
| Part II | Qwen2-VL (2024) | M-RoPE、3D卷积、原生动态分辨率 |
| Part III | Qwen2.5-VL (2025) | 窗口注意力、动态FPS、拒绝采样与CoT |
| Part IV | Qwen3-VL (2025) | Interleaved MRoPE、DeepStack、显式时间戳 |
1. Part I: Qwen-VL:三阶段视觉-语言对齐(2023)
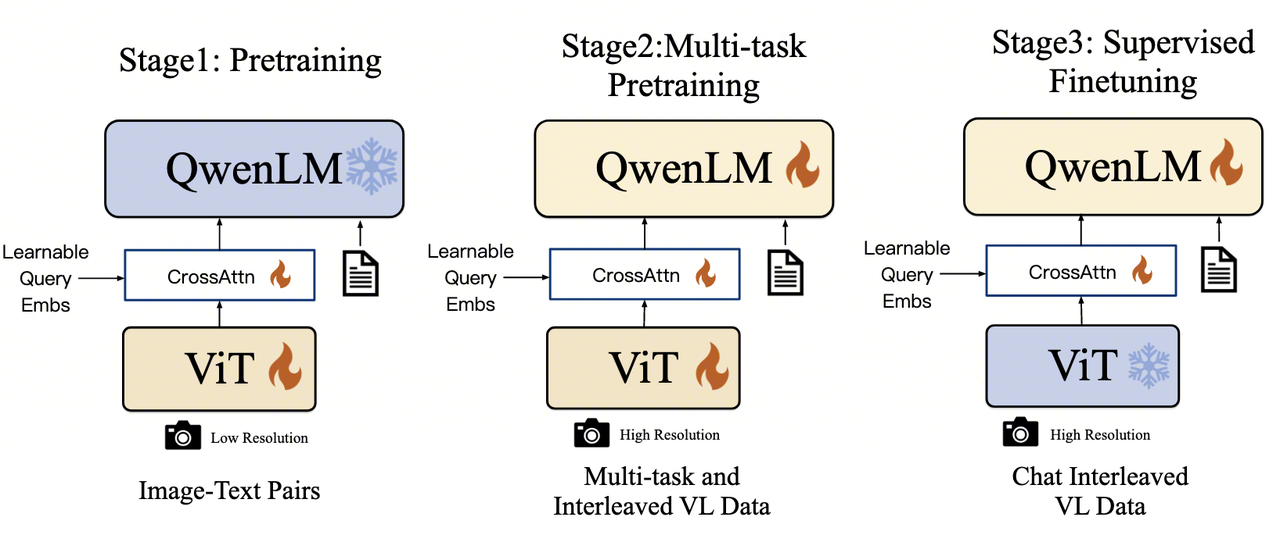
Qwen-VL 是整个系列的起点。基于 Qwen-7B 语言模型,它最核心的贡献并非某项单点技术突破,而是建立了一套三阶段渐进式训练流程:先对齐(Align)、再增强(Enhance)、后对话(Chat)。后续版本虽然改了位置编码、视频输入和训练数据,但基本仍沿着这个分阶段训练框架展开。
1.1. 核心训练思想:渐进式能力构建
Qwen-VL 的训练可以理解为一个逐步放开约束的过程。第一阶段先让视觉特征进入 Qwen-7B 的语言空间,第二阶段再用多任务数据补定位、OCR、VQA 等细粒度能力,第三阶段用指令和对话数据调整交互行为。
这个顺序并不复杂,但很关键。初始阶段如果直接用网页图文噪声去更新 LLM,语言模型原有能力容易被破坏;如果一直冻结 LLM,又很难学到空间关系、文本指令和视觉局部信息之间的对应关系。Qwen-VL 的三阶段设计,本质上是在训练稳定性和视觉-语言融合深度之间取平衡。
三个阶段的目标分别是:
- Align:建立基础的图像-文本映射。
- Enhance:通过多任务学习引入定位、OCR、图表理解等能力。
- Align with Humans:把模型调整成可对话、能遵循指令的 Qwen-VL-Chat。
1.2. 阶段一:预训练 (Stage 1: Pre-training)
第一阶段只解决一个问题:让视觉编码器和适配器把图像压成 LLM 可以接收的特征序列。
数据主要来自网页抓取图文对,例如 LAION、DataComp、Coyo 等。论文中提到,清洗后使用约 14 亿 个图文对。这类数据规模足够大,但标签质量不稳定,很多样本只是图片加短文本、关键词或弱描述。
训练样本格式相对简单:
<img> [视觉特征序列] </img> [文本描述] <eos>
其中 <img>...</img> 标记视觉输入范围,视觉编码器和适配器把图片转换为 256 个向量,后面的文本描述作为自回归生成目标。
这一阶段冻结 Qwen-7B,只训练 ViT 和视觉-语言适配器。原因有两个:一是成本更低,二是避免噪声图文对直接改写 LLM 的语言分布。训练目标仍是标准文本生成,loss 使用交叉熵。换句话说,模型看到图像特征后,需要预测配对文本。
这个阶段学到的是粗粒度对齐,不应期待模型已经具备可靠的定位、OCR 或复杂视觉推理能力。
1.3. 阶段二:多任务预训练 (Stage 2: Multi-task Pre-training)
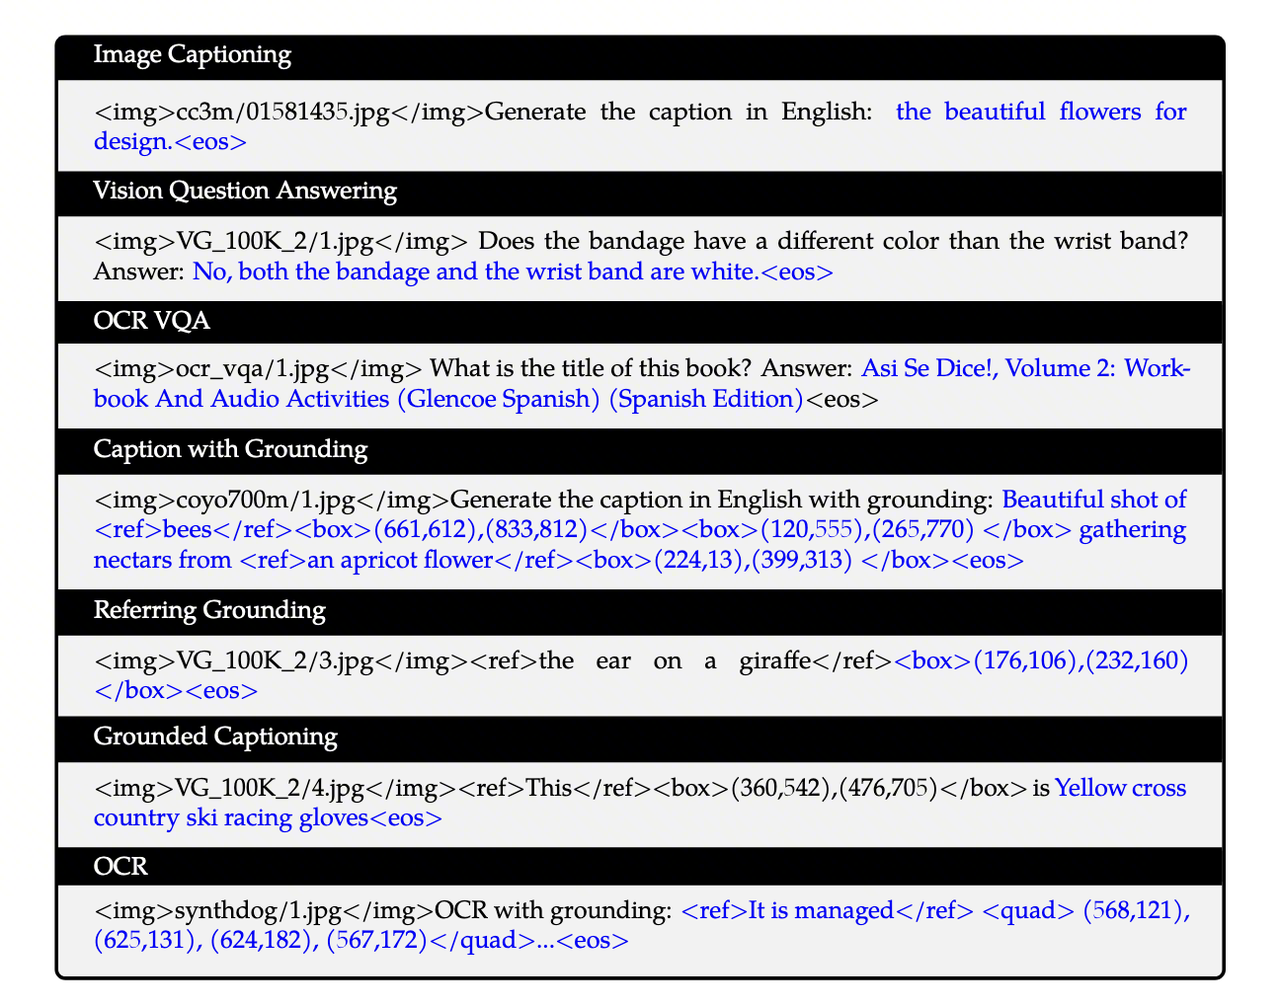
第二阶段开始引入高质量人工标注数据,覆盖 7 类任务。论文图中黑色文本是不计算 loss 的 prompt 或上下文,蓝色文本是需要模型学习的 ground truth。形式上看,这些任务都被统一成序列到序列的文本生成问题。
主要任务包括:
| 任务 | 输入形式 | 生成目标 | 训练信号 |
|---|---|---|---|
| Image Captioning | <img>...</img>Generate the caption in English: | the beautiful flowers for design.<eos> | 根据图像生成描述 |
| VQA | <img>...</img>Does the bandage have a different color than the wrist band? Answer: | No, both the bandage and the wrist band are white.<eos> | 根据图像回答问题 |
| OCR VQA | <img>...</img>What is the title of this book? Answer: | Asi Se Dice!, Volume 2: ...<eos> | 读取图中文字并回答 |
| Caption with Grounding | <img>...</img>Generate the caption in English with grounding: | Beautiful shot of <ref>bees</ref><box>(...)</box> ...<eos> | 同时生成描述和物体框 |
| Referring Grounding | <img>...</img><ref>the ear on a giraffe</ref> | <box>(176,106),(232,160)</box><eos> | 由文字指代生成位置坐标 |
| Grounded Captioning | <img>...</img><ref>This</ref><box>(360,542),(476,705)</box> is | Yellow cross country ski racing gloves<eos> | 描述给定框内区域 |
| OCR | <img>...</img>OCR with grounding: | <ref>It is managed</ref> <quad>(...)</quad>...<eos> | 识别文字并给出四点坐标 |
这张表里最值得注意的是 grounding 格式。Qwen-VL 不只是把定位做成一个额外分类头,而是让模型直接生成 <ref>...</ref>、<box>...</box> 或 <quad>...</quad> 这样的文本序列。这样做牺牲了一些专用检测模型的结构先验,但好处是所有任务都能沿用 LLM 的自回归训练框架。
第二阶段还混入大量纯文本数据,目的是缓解灾难性遗忘。此时模型状态也发生变化:ViT、适配器和 LLM 全部解冻。定位、OCR、图表理解这类任务要求 LLM 理解空间关系和指令意图,只更新视觉侧已经不够。
训练任务和第一阶段一样仍是文本生成,loss 仍是交叉熵。差别在于监督目标从图文描述扩展到了答案、坐标、OCR 文本和多任务指令输出。
1.4. 阶段三:监督微调 (Stage 3: Supervised Fine-tuning, SFT)
第三阶段对应 Qwen-VL-Chat。前两个阶段让模型具备视觉和语言能力,但还没有保证它会按照用户问题组织回答,也没有处理多轮对话格式。
SFT 数据来自多模态指令遵循和对话数据集,一部分由人工编写,一部分由 GPT-4 等更强模型辅助生成。数据形式是多轮对话,可能包含一张或多张图片,并使用论文中提到的 ChatML 格式。
这一阶段重新冻结视觉编码器,只训练适配器和 LLM。理由很直接:视觉编码器在前两个阶段已经负责提取图像特征,SFT 主要调整回答风格、指令遵循和对话行为。
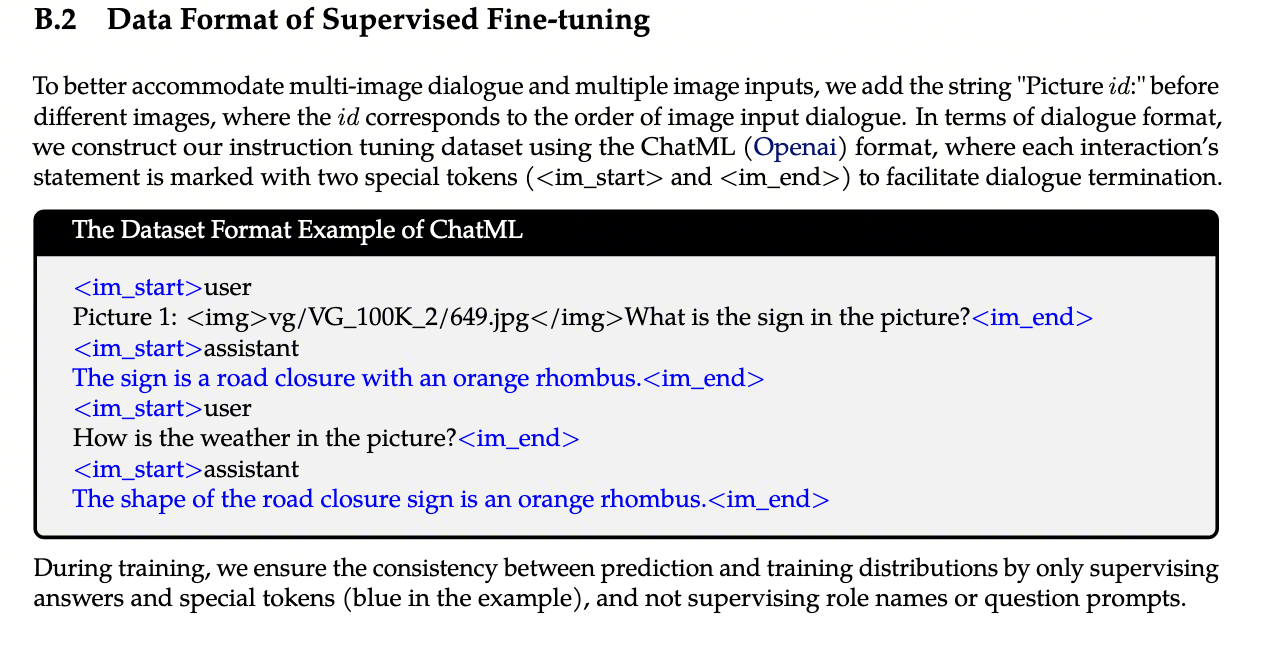
训练目标仍是交叉熵文本生成,但只对答案和特殊标记计算 loss,不监督角色名称或用户提示。这样可以减少训练和推理之间的分布差异:推理时用户问题是给定上下文,模型真正需要预测的是 assistant 的回复。
Part I 小结: Qwen-VL 的重点不是某个单独模块,而是三阶段训练流程本身:先把图像接入 Qwen-7B,再用多任务数据补细粒度视觉能力,最后用 SFT 做对话对齐。它的限制也很清楚:图像统一 resize 到 448×448 会损失细节,没有原生视频输入,绝对位置编码也不适合后续更复杂的多模态坐标建模。这些问题构成了 Qwen2-VL 的主要改动方向。
2. Part II: Qwen2-VL —— 原生动态分辨率与多模态位置编码(2024)
2.1. 相对于 Qwen-VL 的主要变化
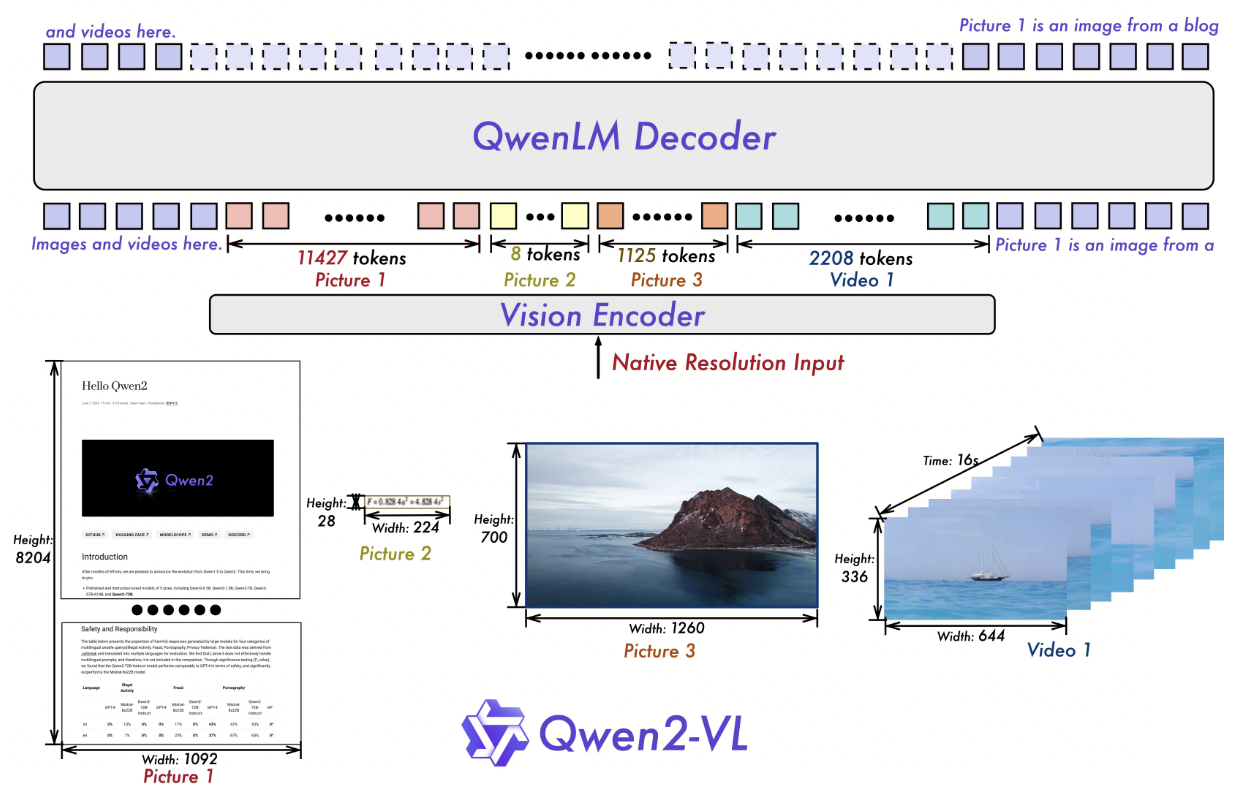
Qwen2-VL 的改动集中在输入形态和位置编码上:
- 去掉原始绝对位置嵌入,引入 2D-RoPE,使图像可以按原始宽高比和动态分辨率输入。
- 引入 M-RoPE,把文本、图像和视频放到统一的时空坐标表示中。
- 使用深度为 2 的 3D 卷积处理视频输入,将连续帧中的 2D patches 合并为 3D tubes。
- 扩展多语言能力。
相比 Qwen-VL,Qwen2-VL 的重点从“如何把图像接到 LLM 上”转向“如何给不同模态分配一致的位置坐标”。M-RoPE 是这一代最核心的设计。
2.2. M-ROPE
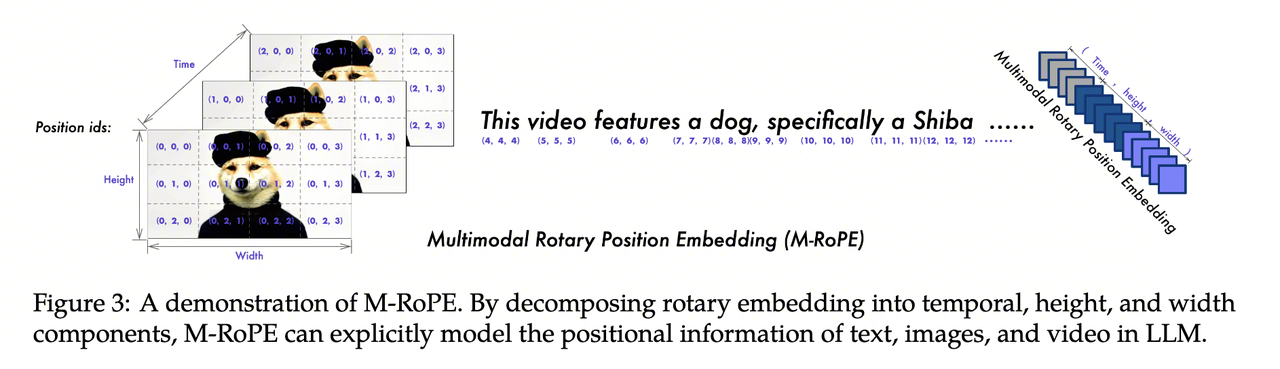
M-RoPE 的目标是给每个 token 分配 $(t, h, w)$ 三个位置分量。文本、图片、视频仍然作为同一条序列送入模型,但位置编码不再只使用一维索引。
2.2.1. 计算流程
输入特征张量为 $X \in \mathbb{R}^{B \times L \times D}$。每个 token 同时带有三个索引:时间索引 $P_t$、高度索引 $P_h$、宽度索引 $P_w$,形状均为 $(B, L)$。对图片来说,时间维通常可以设为常数;对文本来说,可以用序列位置构造等价的一维坐标。
计算过程分三步。
- 沿 hidden dimension 切分特征:
- 分别施加 RoPE:
- 拼回原始维度:
输出 $X_{out}$ 的形状仍是 $(B, L, D)$。后续计算 attention 时,时间差异主要体现在 $X'_t$,空间行列差异主要体现在 $X'_h$ 和 $X'_w$。
2.2.2. 解决问题
2.2.2.1. 多模态数据的”维度不兼容”
文本是一维序列,图片有二维空间结构,视频还多了时间维。如果把所有 token 都压成一维索引,空间和时间信息会混在一起;如果给每种模态单独设计位置编码,又会增加跨模态融合的复杂度。
M-RoPE 的处理方式是统一使用 $(t, h, w)$:
- 文本用 $(i, i, i)$ 表示一维顺序。
- 图片用 $(1, h, w)$ 表示二维空间。
- 视频用 $(t, h, w)$ 表示时空位置。
这样不同模态仍在同一个 embedding 空间里计算 attention,但各自的位置信息有明确分量。
2.2.2.2. 长视频的索引外推问题
视频 token 数量很容易膨胀。假设一个视频有 1000 帧,每帧 256 个 token,总数就是 256,000。如果沿用一维位置索引,位置号 $m$ 会超过 250,000。
RoPE 对超出训练长度的位置比较敏感。当推理位置远大于训练中见过的最大索引,例如训练只覆盖 32k,而推理进入 250k,$\cos(m\theta)$ 对模型来说会落到陌生分布。
M-RoPE 把这个大索引拆成三个较小分量。总 token 可能达到 25 万,但时间索引 $t$ 可能只到 1000,高度索引 $h$ 和宽度索引 $w$ 可能只到 16。这样至少在空间维上,索引仍落在较小范围内;时间维增长也不会同时破坏空间位置表示。
2.2.3. 3D 卷积时空降采样
2.2.3.1. 目的
3D 卷积主要用于压缩视频 token 数。相邻两帧通常有大量冗余,如果每帧都独立切 patch,序列长度会线性增加。
Qwen2-VL 用 3D 卷积把 2 个时间帧融合成 1 个 token。理想情况下,在相同 token 预算下,模型可以读取约 2 倍时长的视频;处理同样时长的视频时,视觉侧 token 数约减半。
2.2.3.2. 实现
传统 ViT 处理视频时可以逐帧切成 $14 \times 14$ patches。若每帧产生 $N$ 个 token,$T$ 帧就是 $T \times N$ 个 token。
Qwen2-VL 使用深度为 2 的 3D 卷积核,一次处理相邻两帧的同一空间区域,形成 $2 \times 14 \times 14$ 的 3D tube。这个设计也让图片和视频可以共享更接近的输入接口:图片可以复制成两帧,视频则按两帧一组压缩。
2.3. 训练
2.3.1. 核心训练原则
Qwen2-VL 仍采用 next-token prediction。训练时只计算文本 token 的交叉熵损失,视觉 token 被 mask 掉,权重为 0。
初始化上,LLM 使用 Qwen2 的 1.5B/7B/72B 版本,ViT 初始化自 DFN,并去掉绝对位置编码,改为 2D-RoPE。
2.3.1.1. 第一阶段:视觉编码器预训练 (ViT Training)
第一阶段训练 ViT 和 adapter,冻结 LLM。数据规模为 600B tokens,主要是大规模弱标注图像-文本对。这个阶段让 ViT 适应 2D-RoPE,并把视觉特征初步对齐到 Qwen2 的语义空间。
2.3.1.2. 第二阶段:全参数预训练 (Full Parameter Pre-training)
第二阶段全参数解冻,ViT、LLM 和 adapter 一起训练。新增 800B tokens,累计达到 1.4T,数据包括混合图文、OCR、交错图文文章、视频数据,也混入纯文本数据以维持语言能力。
这一阶段启用三个机制:Naive Dynamic Resolution 支持任意分辨率图片,M-RoPE 统一图文视频位置编码,3D 卷积把图片和视频整理到统一的视觉输入形式。
2.3.1.3. 第三阶段:指令微调 (Instruction Fine-tuning)
第三阶段冻结 ViT,只训练 LLM。数据使用 ChatML 格式,覆盖多模态对话、长视频问答、Agent 操作序列和纯文本指令。loss 进一步 mask 掉 <|im_start|>user 部分,只计算 assistant 回复。
Part II 小结: Qwen2-VL 主要解决 Qwen-VL 的固定分辨率和视频输入问题。M-RoPE 把文本、图像、视频放到统一坐标系中,3D 卷积降低视频 token 数,动态分辨率减少 resize 带来的信息损失。新的瓶颈也随之出现:高分辨率输入会放大 ViT 全局注意力的二次复杂度,长视频时间建模仍主要依赖相对帧索引,而不是物理时间。
3. Part III: Qwen2.5-VL —— 推理效率、时间建模与训练数据质量(2025)
3.1. 相对于 Qwen2-VL 的主要变化
Qwen2.5-VL 的改动可以归纳为三类:
- 窗口注意力:降低高分辨率图像输入下 ViT 的推理成本。
- 动态 FPS 采样:把动态分辨率思想扩展到时间维度,使模型能处理不同采样率的视频。
- 绝对时间 MRoPE:把时间位置从相对帧号改成与真实时间对齐的位置 ID。
这三项改动都围绕一个问题展开:Qwen2-VL 已经支持图像动态分辨率和视频输入,但高分辨率图像、长视频和非均匀时间间隔会继续放大计算和位置编码压力。
3.2. 窗口注意力机制 (Window Attention)
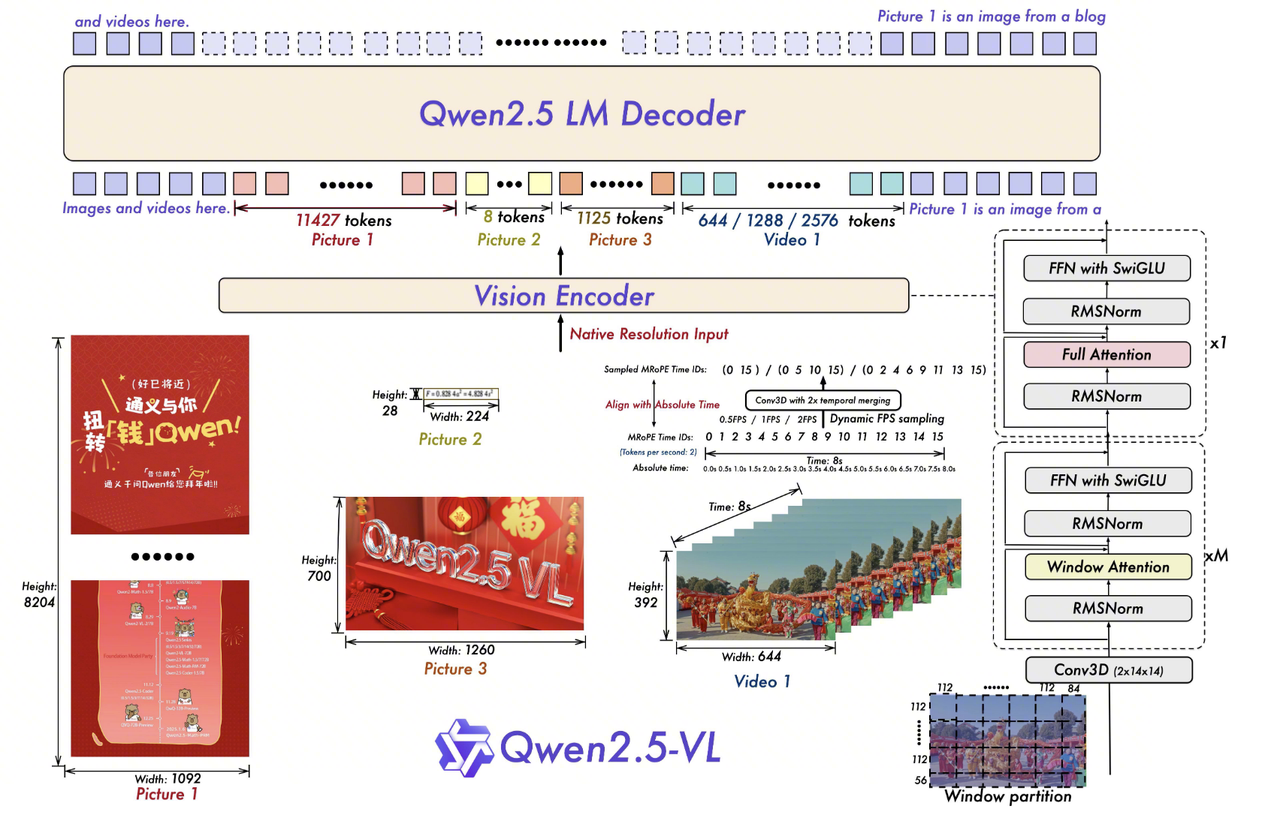
传统 ViT 对所有视觉 token 做全局 attention,复杂度为 $O(N^2)$。动态分辨率输入提高后,$N$ 会随图像面积增加,全局 attention 很快成为瓶颈。Qwen2.5-VL 用窗口注意力把大部分层的计算限制在局部窗口内,使整体复杂度更接近线性增长。
3.2.1. 实现原理与计算流程
输入图像记为 $H \times W$。Qwen2.5-VL 会把 $H, W$ 调整为 28 的倍数,再按 $14 \times 14$ patch 切分。总 token 数为:
\[L = (H/14) \times (W/14)\]展平后的视觉特征形状为 $(1, L, D)$,其中 $D$ 是 hidden size,例如 1280。
窗口大小是 $112 \times 112$ 像素,对应 $8 \times 8 = 64$ 个 patches。窗口数为:
\[N_{win} = \frac{L}{8 \times 8} = \frac{L}{64}\]窗口划分后,形状可以理解为 $(N_{win}, 64, D)$。每个窗口内部独立计算 self-attention:
\[\text{Attention}(Q, K, V) = \text{Softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]单个窗口的 attention 规模固定为 $64^2$,总复杂度约为 $N_{win} \times 64^2$。因为 $N_{win}$ 与 $L$ 成正比,所以这部分计算随图像面积近似线性增长。
窗口注意力的代价是跨窗口信息交换变弱。Qwen2.5-VL 没有让每一层都做局部注意力,而是在索引为 {7, 15, 23, 31} 的层保留 full self-attention,用少数全局层补跨窗口交互。
3.3. 动态 FPS 采样 (Dynamic FPS Sampling)
Qwen2-VL 已经用 3D tube 处理视频,但时间采样仍需要更清楚地表达。Qwen2.5-VL 允许不同 FPS 的输入,并把真实时间间隔交给后面的绝对时间 MRoPE 表示。
3.3.1. 实现原理与计算流程
视频仍按 3D tube 组织。空间 patch 大小为 $14 \times 14$,时间 stride 为 2,即每 2 帧聚合一次。若视频采样 $T$ 帧,分辨率为 $H \times W$,token 数不是:
\[T \times (H/14) \times (W/14)\]而是:
\[\frac{T}{2} \times (H/14) \times (W/14)\]这样 token 数约减半,同时每个 token 含有短时间窗口内的运动信息。模型不要求固定 1 FPS,可以接收 0.5 FPS 或 2 FPS 的帧序列;关键是每个 tube 对应的真实时间要被位置编码记录下来。
3.4. 绝对时间 MRoPE (Multimodal Rotary Position Embedding with Absolute Time)
Qwen2-VL 中的帧位置更接近相对帧号:Frame 0、Frame 1、Frame 2。这个表示无法区分 Frame 1 到 Frame 2 是 0.1 秒还是 10 秒。
Qwen2.5-VL 的改动是把时间位置 ID 和视频中的真实时间对齐。空间部分仍沿用 MRoPE 的高度、宽度位置,时间部分不再只表示第几帧,而是表示该视觉 token 对应的视频秒数。
3.4.1. 实现原理与计算流程
输入仍然是一组视觉 token 及其位置索引。对于视频中某个 token,需要同时确定三类位置:
- $ID_t$:时间位置,来自该帧或 tube 在视频中的真实时间。
- $ID_h$:高度位置,对应视觉 patch 的行坐标。
- $ID_w$:宽度位置,对应视觉 patch 的列坐标。
计算过程可以拆成四步。
先确定视频采样后的时间戳。假设第 $i$ 个视觉 tube 覆盖的视频时间为 $t_{abs}^{(i)}$,单位为秒。这个时间可以来自采样帧的时间戳,也可以取两帧 tube 的代表时间。
把真实时间映射成 RoPE 使用的位置 ID。Qwen2.5-VL 不再使用连续帧号 $k$,而是:
其中 $v$ 是每秒对应的位置 ID 单位数。若 $v=2$,0.0s、0.5s、2.0s 三个位置会分别映射为:
\[0,\quad 1,\quad 4\]这意味着视频位置 ID 可以是跳跃的,例如 $(0, 12, 48)$,而不是普通 Transformer 中常见的连续 $(0, 1, 2)$。跳跃本身不是异常,而是对真实时间间隔的编码。
- 将 MRoPE 的三路位置分别作用到特征子空间。和 Qwen2-VL 的 M-RoPE 一样,hidden dimension 会被分成时间、高度、宽度三段:
然后分别施加旋转:
\[X'_t = \text{RoPE}(X_t, ID_t), \quad X'_h = \text{RoPE}(X_h, ID_h), \quad X'_w = \text{RoPE}(X_w, ID_w)\]最后拼回完整特征:
\[X_{out} = \text{Concat}(X'_t, X'_h, X'_w, \text{dim}=-1)\]- 在 attention 中利用 RoPE 的相对位置性质。对两个视频 token $i, j$,时间部分的相位差由 $ID_t^{(i)} - ID_t^{(j)}$ 决定:
如果两帧之间只隔 0.5 秒,$\Delta_t$ 可能是 1;如果隔了 1.5 秒,$\Delta_t$ 可能是 3。模型看到的不再只是“相邻帧”或“隔两帧”,而是与真实时间跨度对应的旋转差。这个差异对动作节奏、事件顺序和长视频定位更重要。
3.5. 三个机制的配合方式
这三项机制分别作用在视频输入链路的不同位置。
第一步是输入压缩。动态 FPS 采样决定取哪些帧,3D tube 再把相邻 2 帧的同一空间 patch 合成一个视觉 token。若视频采样 $T$ 帧,token 数从 $T \times H/14 \times W/14$ 变为 $T/2 \times H/14 \times W/14$,先把序列长度压下来。
第二步是时间标注。每个 tube 不只保留顺序编号,还会根据它对应的视频秒数计算 $ID_t$。因此,同样是相邻两个视觉 token,如果一个来自 0.5 秒间隔,另一个来自 2 秒间隔,它们在时间 RoPE 上产生的相位差不同。
第三步是视觉编码。带有 $(ID_t, ID_h, ID_w)$ 的 token 进入 ViT 后,大多数层只在 $8 \times 8$ 局部窗口内做 attention,用较低成本提取局部视觉特征;少数层保留 full self-attention,负责跨窗口的信息交换。
这套组合的目的不是单纯“支持视频”,而是把三个约束同时处理掉:视频 token 过长、采样时间间隔不均匀、高分辨率输入导致全局 attention 成本过高。
3.6. 与 Swin Transformer Shifted Window 的不同
3.6.1. 核心区别:信息的“跨窗口”交互方式
Swin Transformer 用 shifted window 处理跨窗口通信:第 $l$ 层使用标准窗口,第 $l+1$ 层把窗口平移,让相邻窗口的信息通过重叠区域传播。它通常不显式做全图 full attention。
Qwen2.5-VL 不移动窗口。大多数层使用固定、不重叠窗口,少数层插入 full self-attention。也就是说,它用“局部窗口 + 间隔全局层”的方式替代 Swin 的交替移动窗口。
3.6.2. 为什么不选 Swin 的 Shifted Window?
原因主要是动态分辨率。Swin 的 shifted window 在固定尺寸图片上很自然,但 Qwen2.5-VL 要处理不同宽高比和动态尺寸输入。移动窗口会引入更多 padding 和 masking,边界不整齐时实现复杂度和算子效率都会受影响。
固定窗口配合少数全局层更直接。论文中提到只有四层使用 full self-attention,计算成本仍随输入规模近似线性增长;同时,这几层可以借助 FlashAttention 等算子控制实际开销。
3.7. 训练
Qwen2.5-VL 的训练分为预训练和后训练两大部分,共 5 个阶段。数据规模从上一代的 1.2T 扩展到 4.1T tokens,重点从“接入视觉”转向“高分辨率、长视频、推理数据和偏好对齐”。
3.7.1. 预训练 (Pre-Training)
阶段 1:ViT 初始对齐 (Visual Encoder Initialization)
第一阶段只训练 ViT,LLM 不参与或被冻结。由于 Qwen2.5-VL 的 ViT 重新设计,需要先让视觉编码器具备基本像素到语义特征的转换能力,并初步对齐语言空间。
训练数据包括基础图文对、视觉知识数据和 OCR 数据。这个阶段不追求复杂推理,重点是建立稳定的视觉表征。
阶段 2:全参数多模态预训练 (Multimodal Pre-Training)
第二阶段解冻所有参数,ViT 和 LLM 一起训练。数据变得更复杂,包括图文交错数据、VQA、多任务学习数据以及纯文本数据。纯文本数据的作用仍是维持 LLM 原有语言能力,避免视觉训练挤占语言分布。
这一阶段上下文长度限制在 8,192 (8k)。
阶段 3:长上下文与高分辨率强化 (Long-Context Pre-Training)
第三阶段继续全量训练,把上下文长度从 8k 扩展到 32,768 (32k)。训练数据加入长视频、Agent 轨迹和高分辨率文档,针对的是长时间跨度、复杂操作序列和细粒度文档识别。
为了减少不同图像尺寸导致的负载不均衡,训练中使用 dynamic packing,把不同长度样本打包到同一批计算中,提高 GPU 利用率。
3.7.2. 后训练 (Post-Training)
阶段 4:监督微调 (Supervised Fine-Tuning, SFT)
SFT 阶段冻结 ViT,只微调 LLM。数据使用 ChatML 格式,显式注入视觉 embedding。数据量约 200 万 (2M) 条,其中 50% 是纯文本对话,50% 是多模态对话,包括图文和视频文本任务。
这里的数据过滤比前几代更重要。论文提到两类方法:一类是规则过滤,用于去重、去除破损数据;另一类是模型过滤,用 72B 模型给样本打分,剔除图文不相关的低质量数据。
针对数学、代码和部分 VQA 任务,Qwen2.5-VL 还使用拒绝采样构造 CoT 数据:让模型生成多个候选,用 ground truth 或 verifier 筛掉错误答案,再把答案正确且推理过程质量较好的样本放回 SFT 数据。
阶段 5:直接偏好优化 (Direct Preference Optimization, DPO)
DPO 阶段继续冻结 ViT,优化 LLM。训练数据是偏好对:同一个问题对应一个较好回答 $y_w$ 和一个较差回答 $y_l$。论文中 DPO 主要用于图像-文本和纯文本数据,目标是减少幻觉并提升偏好对齐。
3.7.3. 拒绝采样
拒绝采样可以看作 Best-of-N 数据构造。它不直接改变模型结构,而是改变 SFT 数据的来源:模型先自己生成多个候选,再用答案验证和质量过滤选出可训练样本。
在 Qwen2.5-VL 中,这个过程主要用于数学问题、代码生成和领域特定 VQA。
- 使用中间版本 Qwen2.5-VL,对同一个 prompt 生成 $N$ 个回答。
- 对候选回答做硬验证。数学题检查最终答案,代码题运行测试用例,VQA 任务对照 ground truth。
- 对答案正确的候选继续做质量过滤,去除 code-switching、重复模式、过长回答和格式错误样本。
- 把保留下来的 CoT 样本加入 SFT 数据集。
这个方法解决的是两个数据问题。第一,很多题库只有 question 和 final answer,没有中间推理过程;拒绝采样可以生成可验证的 CoT。第二,人类写的推理过程有时和模型自身分布差异较大,模型自生成且通过验证的样本更容易被当前模型吸收。
CoT 可以通过系统提示、格式约束和 few-shot 示例诱导生成。常见格式如下:
<thinking>
第一步:识别图像左上角,发现一个红色物体...
第二步:根据形状判断这是一个苹果...
...
</thinking>
<answer>
这是一个苹果
</answer>
如果输出不符合格式,可以在采样环节直接丢弃或重试。few-shot 示例则给模型一个可模仿的推理样式,例如:
问题: 图中的三角形面积是多少?
回答: 首先,我看到底边长为 4,高为 3。根据三角形面积公式 1/2*底*高,计算得出 1/2*4*3=6。答案是 6。
问题(当前任务): 图中的圆形面积是多少?
回答: … (模型会模仿上面的语气和步骤开始写)
过滤分两层。规则过滤处理明显坏样本,例如中英文无意义切换、n-gram 重复率过高、长度异常和 <thinking> 标签不闭合。模型过滤处理规则难以覆盖的问题,通常用 72B 模型或 reward model/verifier 打分,重点看视觉-文本一致性、逻辑连贯性、有用性和安全性。对 VLM 来说,视觉-文本一致性尤其关键:如果 CoT 写“左上角有一只蓝色的狗”,但图中实际是红色的猫,这类样本即使推理格式完整也不能进入训练集。
Part III 小结: Qwen2.5-VL 的核心不是新增一个单点能力,而是把 Qwen2-VL 的几个压力点逐一补上:窗口注意力控制高分辨率输入成本,动态 FPS 和绝对时间 MRoPE 改进视频时间表示,4.1T tokens 与拒绝采样提高训练数据覆盖和 CoT 质量。后续 Qwen3-VL 继续推进的问题,是视觉信息到底应该在 LLM 的哪一层、以什么方式参与计算。
4. Part IV: Qwen3-VL —— 走向更深层的视觉-语言融合(2025)
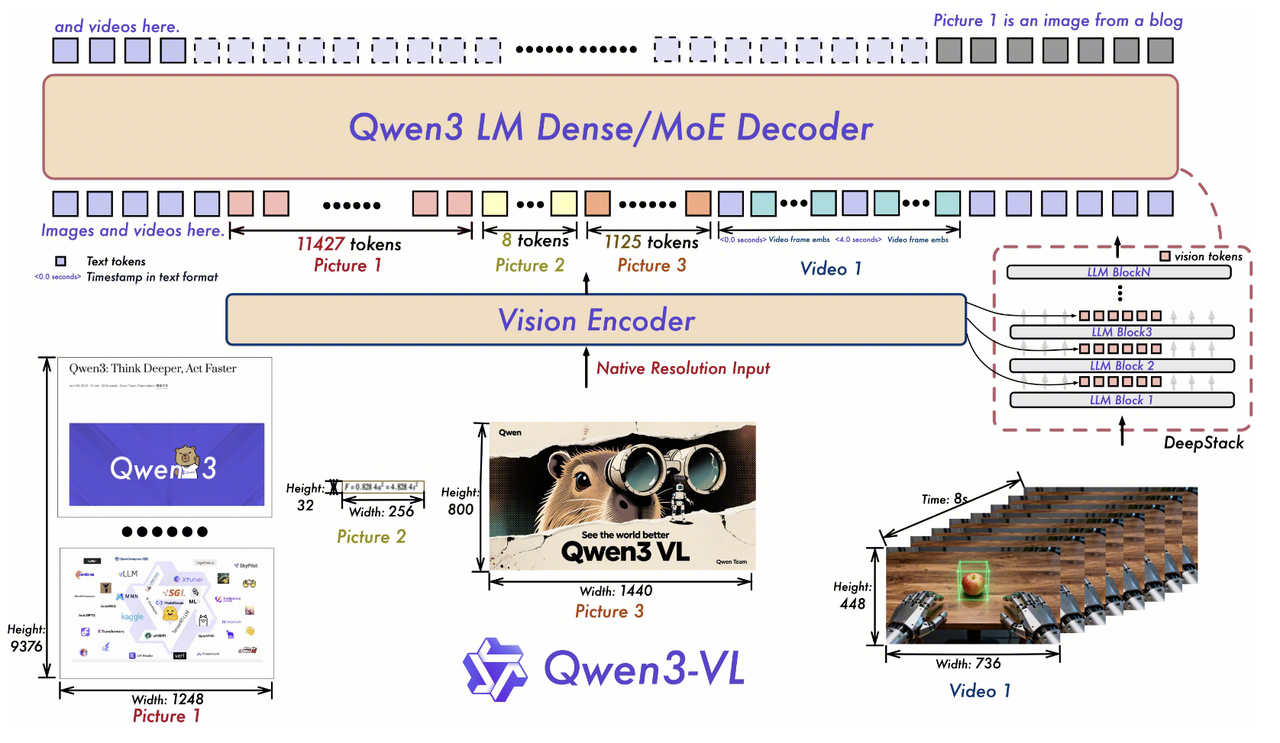
Qwen3-VL 继续处理 Qwen2.5-VL 暴露出的两个问题:一是 MRoPE 分块后不同轴接触到的频率范围不均衡,二是视觉信息只在输入端进入 LLM,融合深度有限。它的主要改动落在 Interleaved MRoPE、DeepStack 和显式视频时间戳上。
4.1. 核心架构创新
4.1.1. Interleaved MRoPE(交错式多维旋转位置编码)
Qwen2.5-VL 使用标准 MRoPE,把位置嵌入维度分块,分别分配给时间 $t$、高度 $h$ 和宽度 $w$。这种做法清楚,但会带来频谱不平衡:某些空间或时间轴只能接触到特定频率范围,长视频和细粒度空间建模可能受影响。
Qwen3-VL 改用 Interleaved MRoPE,不再把 $t, h, w$ 简单分成连续块,而是把三个轴的分量交错分布到整个嵌入维度中。这样每个时空轴都能覆盖低频和高频波段,位置编码的频率分配更均衡。
4.1.2. DeepStack(深层视觉融合机制)
传统视觉-语言对齐通常使用 ViT 最后一层输出,再经过 MLP 投影接入 LLM。这个接口简单,但视觉信息主要在输入端出现,底层纹理、小物体等细粒度信息可能在深层语义特征中被压掉。
Qwen3-VL 引入 DeepStack,受 Meng et al., 2024 启发,从 SigLIP-2 的不同层级提取视觉 token。低层到高层的视觉特征经过投影后,通过残差连接注入 LLM 的前三层。这个设计的价值在于:模型可以同时使用高层语义和低层视觉细节,而且不需要把更多视觉 token 串行拼进上下文,因此不会额外拉长序列。
4.1.3. Explicit Video Timestamp(显式文本时间戳)
Qwen2.5-VL 用 time-synchronized MRoPE 表示绝对时间,但长视频会产生很大且稀疏的位置 ID,数据构造也更依赖采样策略。
Qwen3-VL 改用文本形式的显式时间戳。它使用长度自适应采样,并在视频帧组前插入时间戳 token,例如 <3.0 seconds>。训练时混合秒数格式和 HMS 格式:
- 秒格式:
<125.5 seconds> - HMS 格式:
<00:02:05>
这种表示把时间信息直接放进文本序列,有利于视频定位和 dense captioning,也降低了模型对固定采样率的依赖。
5. 总结与展望
5.1. 四代模型的技术演进脉络
Qwen-VL 系列四代模型的变化,可以按视觉编码器、位置编码、视频处理和训练流程拆开看:
| 维度 | Qwen-VL (2023) | Qwen2-VL (2024) | Qwen2.5-VL (2025) | Qwen3-VL (2025) |
|---|---|---|---|---|
| 视觉编码器 | ViT + 固定分辨率 | ViT + 原生动态分辨率 | ViT + 窗口注意力 | SigLIP-2 + DeepStack |
| 位置编码 | 绝对位置编码 | M-RoPE (分块式) | M-RoPE + 绝对时间 | Interleaved MRoPE |
| 视频处理 | 不支持 | 3D卷积时空降采样 | 动态FPS采样 | 显式文本时间戳 |
| 训练范式 | 三阶段渐进训练 | 三阶段(ViT→全参→SFT) | 五阶段(+长上下文+DPO) | 延续并深化 |
| 主要变化 | 建立基础训练流程 | 多模态统一位置编码 | 推理效率与数据质量 | 深层视觉融合 |
5.2. 几条设计线索
这四代模型有几条连续的设计线索:
训练稳定性优先:先冻结后解冻的思路贯穿多代模型。视觉侧先对齐,语言侧再参与复杂任务训练。
统一序列化接口:定位坐标、OCR 文本和视频时间戳都被表示为文本序列,尽量复用 LLM 的自回归建模能力。
时间表示逐步显式化:视频时间从无原生支持,到相对帧索引,再到绝对时间位置编码,最后变成显式文本时间戳。
数据质量权重上升:从网页图文对到多任务标注,再到拒绝采样生成 CoT,训练数据工程在后几代模型中变得更重要。
5.3. 后续问题
从 Qwen3-VL 的 DeepStack 可以看到,后续问题不只是“视觉编码器接在哪里”,而是视觉特征应该以什么粒度、在 LLM 的哪些层参与计算。显式时间戳也说明,视频理解并不能只靠更长 context window,时间表示和采样策略本身会影响模型能否做稳定定位和长视频描述。
我后续更关注两点:一是深层视觉注入是否会带来额外训练不稳定或模态干扰,二是显式时间戳在不同视频采样率和长视频问答任务上的泛化边界。
6. 延伸阅读
以下论文和资料与本文涉及的技术点直接相关:
视觉编码器基础
An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale (ViT, Dosovitskiy et al., 2020) —— Qwen-VL 系列所依赖的视觉编码器骨干,提出了将 Transformer 应用于图像 patch 序列的基本形式。
Swin Transformer: Hierarchical Vision Transformer using Shifted Windows (Liu et al., 2021) —— 文中讨论 Qwen2.5-VL 窗口注意力时的重要对比对象,其 Shifted Window 机制与 Qwen2.5-VL 的 2D-RoPE 窗口注意力形成有趣对照。
Sigmoid Loss for Language Image Pre-Training (SigLIP, Zhai et al., 2023) —— Qwen3-VL 将视觉编码器切换为 SigLIP-2。SigLIP 用 sigmoid 损失替代 softmax 对比损失,是理解这一替换的基础材料。
位置编码与序列建模
RoFormer: Enhanced Transformer with Rotary Position Embedding (Su et al., 2021) —— M-RoPE 的理论基础。Qwen-VL 系列多代位置编码都建立在 RoPE 的相对位置性质上。
ViViT: A Video Vision Transformer (Arnab et al., 2021) —— 理解 Qwen2-VL 3D 卷积时间降采样设计的重要参考,讨论了将 ViT 扩展到视频理解的多种架构方案。
视觉-语言融合架构
Flamingo: a Visual Language Model for Few-Shot Learning (Alayrac et al., 2022) —— 多模态大模型的里程碑工作,其 cross-attention 融合机制是理解 Qwen3-VL DeepStack 深层视觉融合的重要背景。
DeepStack: Deeply Stacking Visual Tokens is Surprisingly Simple and Effective for LMMs (Meng et al., 2024) —— Qwen3-VL 的重要参考,通过将视觉 token 分组注入 LLM 不同层实现深层融合。
Visual Instruction Tuning (LLaVA, Liu et al., 2023) —— 视觉指令微调的代表性工作,确立了「视觉编码器 + 投影层 + LLM」的经典多模态架构。
训练策略与对齐
Direct Preference Optimization: Your Language Model is Secretly a Reward Model (DPO, Rafailov et al., 2023) —— Qwen2.5-VL 训练流程的关键技术,跳过显式奖励模型直接从偏好数据优化策略,本文 Part III 中有详细讨论。
Self-Rewarding Language Models (Yuan et al., 2024) —— 与 Qwen2.5-VL 的拒绝采样策略相关,讨论模型自我评估和迭代提升。
动态分辨率处理
- Patch n’ Pack: NaViT, a Vision Transformer for any Aspect Ratio and Resolution (Dehghani et al., 2023) —— 理解 Qwen2-VL 原生动态分辨率设计的重要参考,NaViT 通过 sequence packing 实现任意分辨率输入,与 Qwen 系列的动态分辨率方案异曲同工。
同期竞品对比
- InternVL: Scaling up Vision Foundation Models and Aligning for Generic Visual-Linguistic Tasks (Chen et al., 2023) —— 将视觉编码器扩展到 6B 参数的代表性工作,与 Qwen-VL 系列在架构设计和训练策略上形成有意义的对比。
特别推荐: RoPE 提出者苏剑林先生的个人博客 科学空间。其中关于 RoPE 数学推导、NTK-aware 外推和多模态位置编码扩展的文章,对理解 M-RoPE 及其变体很有帮助。
本文为个人论文阅读笔记整理,如有疏漏欢迎指正。
Leave a Comment