CapRL: 用强化学习激发视觉语言模型的描述能力
Published:
Paper: CapRL: Stimulating Dense Image Caption Capabilities via Reinforcement Learning (CVPR 2025) Authors: Xing et al. TL;DR: CapRL 把图像描述质量转化为一个可验证问题:如果一段 caption 足够完整,纯文本 LLM 应该能只根据它回答图像相关的 MCQ。这个设定避开了 LVLM-as-a-Judge 对长度和风格的偏好,也给 RL 训练提供了更稳定的奖励信号。
1. 引言:图像描述的奖励定义问题
图像描述看起来是一个直接的生成任务:给定图片,输出一段文字。但真正困难的地方不在生成本身,而在评价标准。什么样的描述算好?只写出主体不够,堆满细节也可能出错。对 dense caption 来说,目标更接近“尽量完整地传递图像信息,同时不引入幻觉”。
本文解读的 CapRL 主要处理这个问题:如何让 VLM 生成信息密度更高、事实更可靠的描述,并把这个目标放进强化学习框架里优化。
传统做法通常先用 SFT 让模型模仿人工 caption。SFT 的问题比较明确。
- 标注成本高。高质量 dense caption 需要人工观察大量细节,规模化成本很高。
- 覆盖有限。模型容易学到训练集中常见的描述模板,对同一张图中可被关注的细节覆盖不稳定。
- 评价主观。BLEU、ROUGE 这类文本重叠指标很难判断描述是否真正完整、准确。
因此,RL 是一个自然选择:让模型自己探索不同描述,并用奖励函数筛选更好的输出。难点也随之转移到奖励函数本身。图像描述不是数学题,奖励如果仍依赖一个模型主观打分,训练很容易学到评估器的偏好,而不是学到更好的 caption。
2. 现有 RL 方法的困境:Reward Hacking
一种常见思路是用另一个 LVLM 当 judge,让它根据图像和 caption 打分。问题在于 judge 本身也有偏好。例如,通用 LVLM 可能偏爱更长、更详细的回答;某些 reward model 可能偏好短而干净的输出。policy model 只要找到这些偏好,就可以拿到高分,而不必真正描述图像。
2.1 “裁判”的偏见
LVLM-as-a-Judge 的奖励不是纯粹的事实校验。它会把内容覆盖、语言风格、长度、组织方式混在一个分数里。这个分数一旦进入 RL,模型就会优先优化最容易被 judge 捕捉到的特征。
论文中讨论了两类典型偏差:
- 通用 LVLM 可能偏爱冗长描述。
- 通用 reward model 可能偏爱简洁输出。
2.2 策略模型的”钻空子”
这种偏差会被 policy model 利用。面对偏爱冗长的 judge,模型可能输出大量看似结构完整、实际与图像无关的文字:
# 面对偏爱冗长的裁判
输出: "我的描述组织得很好,结构很完善,首先我要说明..."
结果: 高分,但没有描述图像内容

# 面对偏爱简洁的裁判
输出: "图中有三只动物"
结果: 高分,但信息量极低
这就是 Reward Hacking:奖励上升,但目标任务没有变好。更严重时,训练会出现 collapse,例如 caption 长度突然膨胀,或直接缩短到几乎没有信息。CapRL 的出发点就是把这类主观评分替换成更可验证的奖励。
3. CapRL 的奖励设计
CapRL 重新定义了“好描述”的判定方式:
一段高质量 caption 应该让看不到图像的纯文本 LLM,仅凭 caption 回答图像相关问题。
这个定义把“描述好不好”变成“问题能否答对”。它有三个直接后果:
- 奖励可验证。MCQ 的答案对错可以直接判定。
- 套话难以拿分。无关的长文本不能提供问题答案。
- 信息覆盖会被鼓励。caption 覆盖的视觉细节越多,支持回答的问题越多。
- 可通过定制化的QA问题,引导模型关注特定类型的视觉信息(如颜色、数量、位置关系等),得到适应不同下游任务需求的 caption。
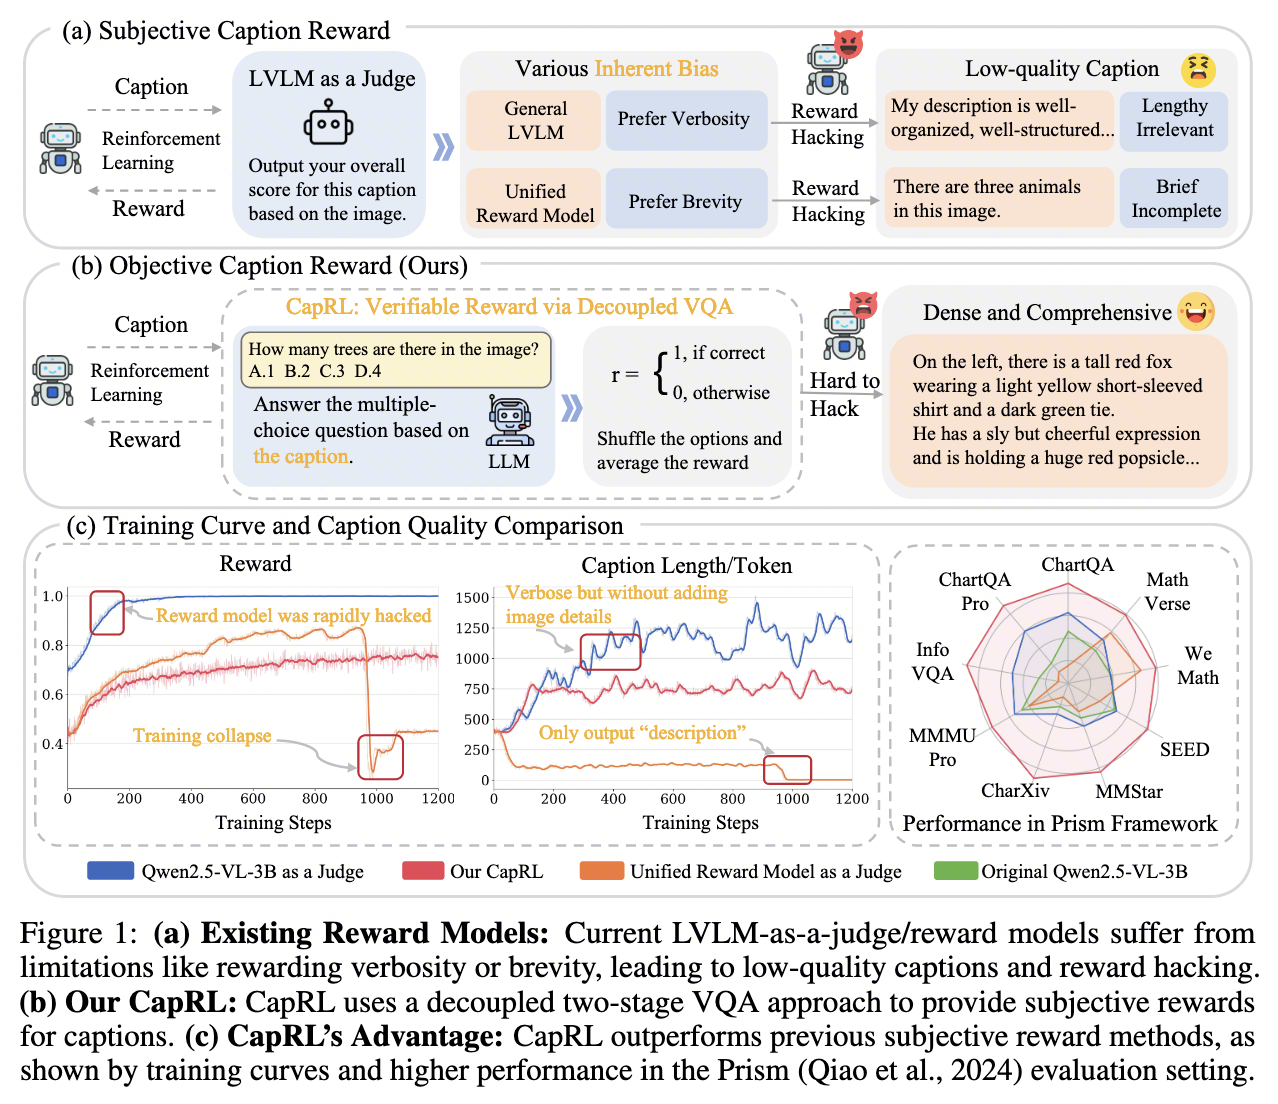
(a) Subjective Caption Reward:问题设置
图中左侧对应传统的主观奖励流程。policy model 生成 caption 后,caption 和图像一起交给 LVLM-as-a-Judge,judge 输出一个综合分数作为 RL 奖励。
这个流程的问题不在于不能打分,而在于分数的含义不够单一。judge 可能把“详细”“简短”“结构清楚”等风格特征也纳入奖励,policy model 便会沿着这些偏好优化。论文给出的例子是,模型为了迎合偏爱冗长的 judge,会生成“Lengthy Irrelevant”的文字;为了迎合偏爱简洁的 reward model,又可能生成“Brief Incomplete”的描述。
(b) Objective Caption Reward:CapRL 的做法
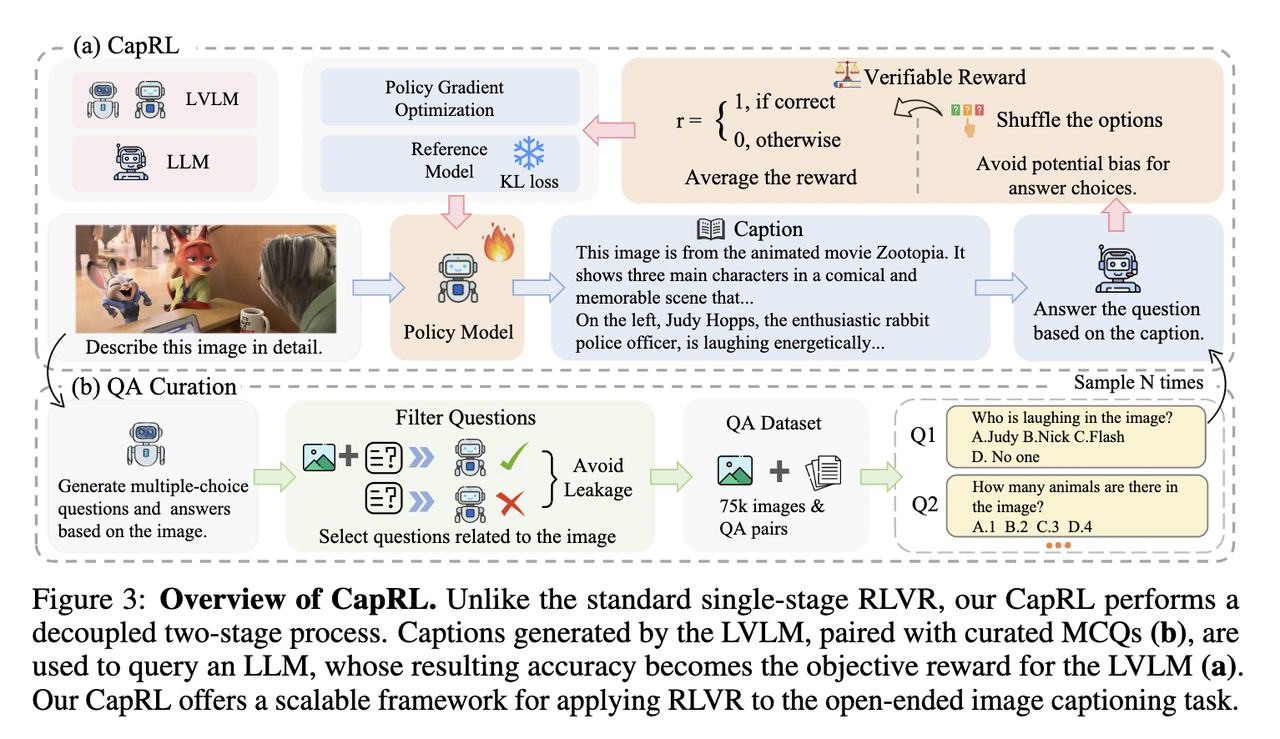
CapRL 使用解耦 VQA 来计算奖励。流程是:policy model 先根据图像生成 caption;随后,一个看不到图像的纯文本 LLM 读取 caption 和该图像对应的 MCQ,并尝试回答问题。答对越多,caption 奖励越高。
这一步的关键在“vision-free”。评估模型看不到原图,因此它无法绕过 caption 直接回答视觉问题。caption 如果缺少颜色、数量、位置关系、文本内容等信息,LLM 在对应问题上就会失分。
(c) Training Curve and Caption Quality Comparison:实验现象
图中左侧 reward 曲线和中间 caption length 曲线主要说明训练稳定性。
- 蓝色曲线使用 Qwen2.5-VL-3B as a Judge。reward 很快到 1.0,同时 caption 长度快速增加,符合“用冗长输出攻击奖励”的模式。
- 橙色曲线使用 Unified Reward Model as a Judge。reward 上升后出现 training collapse,caption 长度也下降到接近零。
- 红色曲线是 CapRL。reward 更平滑,caption 长度没有出现极端膨胀或坍缩。
右侧雷达图展示 Prism Framework 下的任务表现,包含 ChartQA、MathVerse、SEED 等 benchmark。论文图中 CapRL 对应的红色线在多数维度上优于原始模型和另外两类 reward 训练结果。这里更稳妥的解读是:可验证奖励减少了明显的 reward hacking,同时没有牺牲下游多模态任务表现。
4. 高质量 MCQ 数据集构建
CapRL 的奖励质量依赖 MCQ 数据。问题如果不需要看图就能回答,caption 再差也可能拿分;问题如果图片本身无法支持答案,奖励又会变成噪声。因此,论文先构建图像相关的 MCQ,并用筛选流程排除信息泄露。
4.1 第一阶段:图像收集
图像来源包括 ShareGPT4V-1M、DenseFusion-1M 等开源数据集,也包括网络搜集的自然照片、文档、图表、用户界面等类别。
收集后会做质量和安全过滤,去掉低分辨率、过于简单、暴力、色情等不适合样本。同时,研究团队还移除与常见评测基准高度相似的图片,降低 benchmark leakage 风险。
4.2 第二阶段:问答对生成
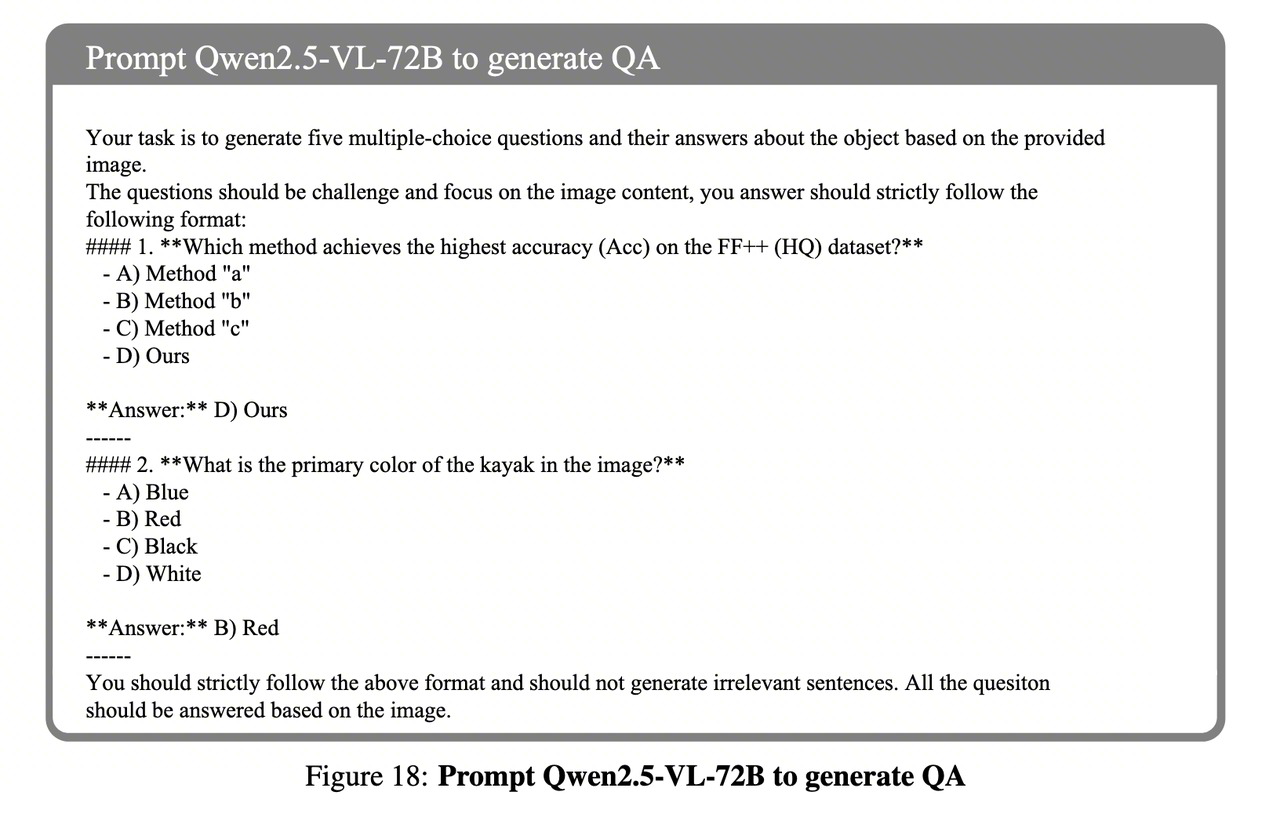
对每张图片,论文使用 Qwen2.5-VL-72B 生成多个与图像内容相关的 MCQ 及正确答案。
4.3 第三阶段:问答对筛选
筛选阶段的目标是消除信息泄露,确保保留下来的问题必须依赖视觉信息。
信息泄露指的是问题不需要看图也能答对。例如,一张图片里有 “Eiffel Tower” 标志,如果问题是 “What is the capital of France?”,模型只靠常识就能回答 “Paris”。这种问题不能用于评估 caption 质量。
论文采用一正一反的双重验证机制:
- 正向验证:把“图片 + 问题”输入 LVLM,要求模型能答对。论文中筛选阶段为了节省成本使用 Qwen2.5-VL-3B。这个条件保证问题确实和图像内容相关,答案能从图像中得到。
- 反向验证:只把“问题”输入同一个 LVLM,不提供图片,要求模型答错。这个条件排除仅靠语言逻辑或常识就能回答的问题。
一个问答对 (q, a) 只有同时满足这两个条件才会被保留。
用论文中的公式表示:
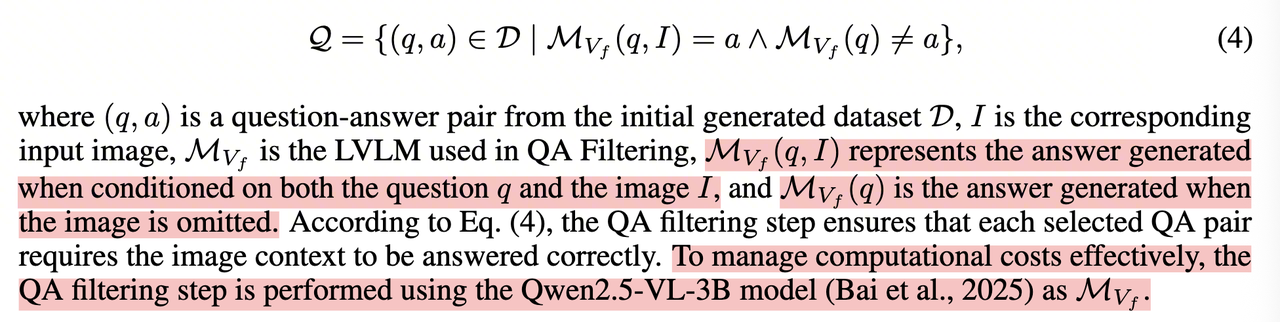
Q是最终筛选出的数据集。(q, a)是一个问答对。D是初始生成的数据集。Mv(q, I) = a表示模型看到图片I和问题q时能答对答案a。Mv(q) ≠ a表示模型只看到问题q时答不对答案a。
5. 方法详解
CapRL 的训练流程可以概括为两步:先由 LVLM 生成 caption,再由 vision-free LLM 根据 caption 回答问题并产生奖励。这个解耦设计让 reward 不再直接来自“裁判对 caption 的主观印象”,而来自 caption 对问答任务的支持能力。
5.1 第一阶段:LVLM 生成图像描述
策略模型是需要训练的 LVLM,论文中使用 Qwen2.5-VL-3B。它接收输入图像和描述指令,例如“详细描述这张图片”,然后生成候选 caption。
5.2 第二阶段:Vision-Free LLM 回答问题
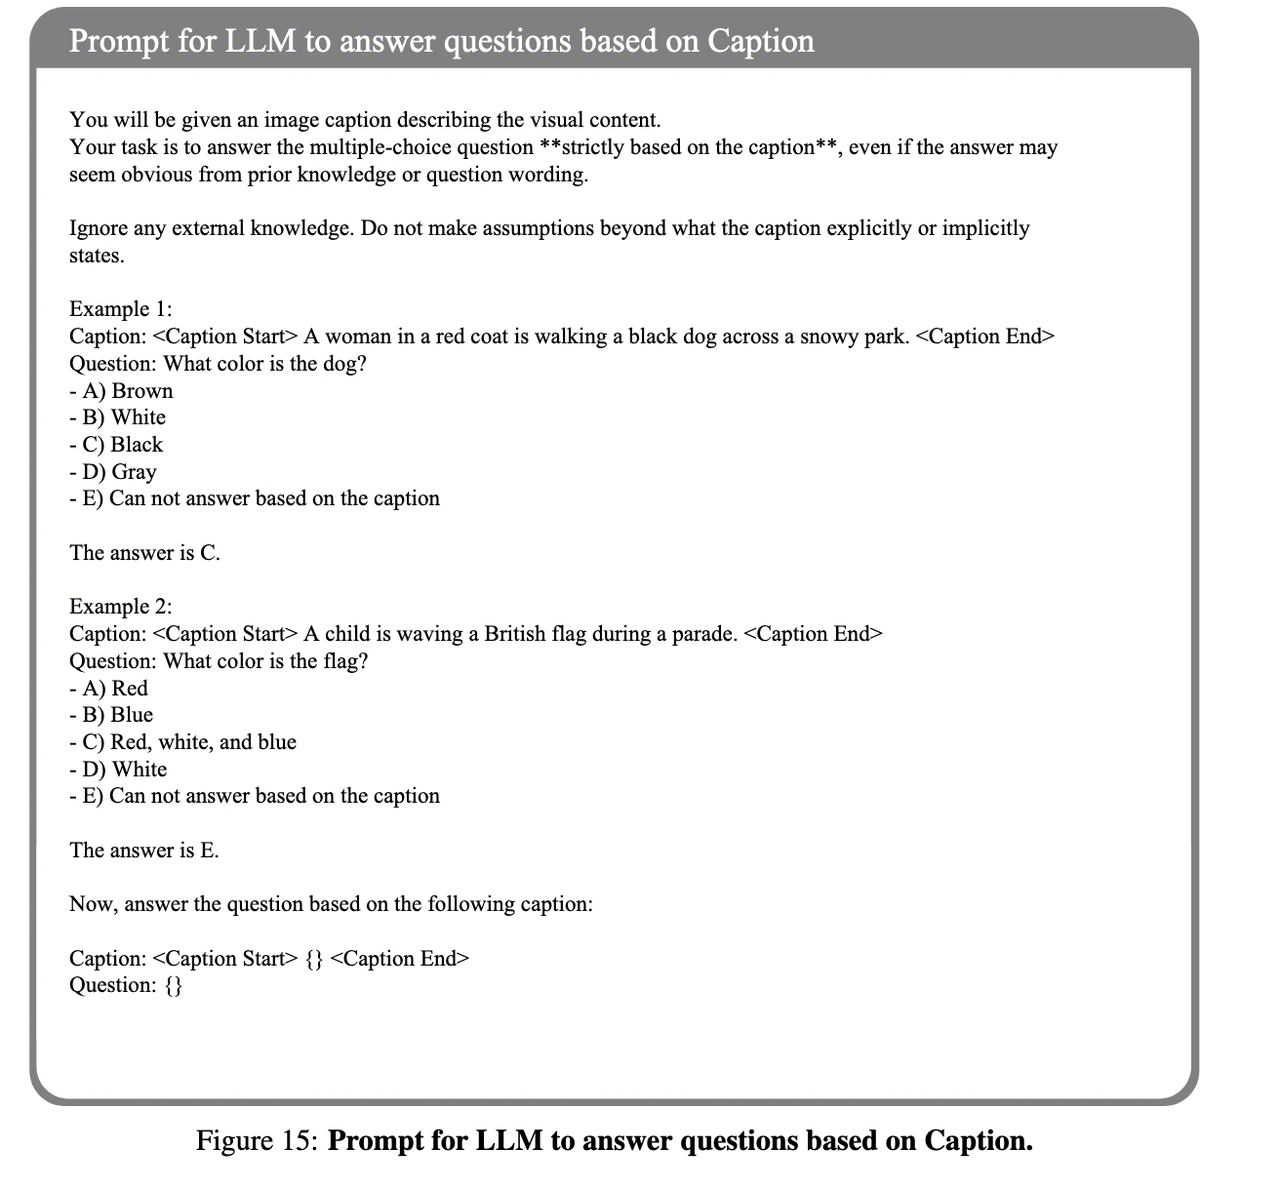
候选 caption 和该图像对应的 MCQ 会一起输入到独立的纯文本 LLM,即 Qwen2.5-3B-Instruct。这个模型无法访问图像,只能依赖 caption 中的信息回答问题。
5.3 奖励计算
纯文本 LLM 根据 caption 回答每个问题。答对记为 1,答错记为 0;多道问题取平均准确率,作为该 caption 的奖励。
对于生成的描述 $c$ 和问题集合 $\{q_1, q_2, ..., q_n\}$:
\[R(c) = \frac{1}{n}\sum_{i=1}^{n}\mathbb{1}\left[\text{LLM}(c, q_i) = a_i\right]\]其中:
- $c$ 是生成的图像描述。
- $q_1, q_2, ..., q_n$ 是对应的问题集合。
- $a_i$ 是第 $i$ 个问题的正确答案。
- $\mathbb{1}[\cdot]$ 是示性函数,条件为真时取 1,否则取 0。
这个奖励直接对应“caption 是否包含回答问题所需的信息”。如果 caption 更准确地描述物体数量、空间关系、图表内容或可见文字,vision-free LLM 的答题准确率就更高。
5.4 模型优化与训练
得到奖励后,CapRL 使用 GRPO 更新第一阶段的 LVLM。模型反复生成 caption,经由第二阶段奖励机制得到反馈,再根据奖励优化参数。
整个闭环是:
生成描述 -> 客观评估 -> 获得奖励 -> 优化模型 -> 生成新的描述
6. CapRL 解决了什么问题?
CapRL 的贡献可以落到四个具体问题上。
第一,它缓解了 SFT 对固定标注的依赖。SFT 只能学习已有 caption 的分布,RL 允许模型探索不同描述方式。但这并不意味着完全摆脱数据成本,因为 MCQ 的生成和筛选仍然需要高质量图像、强 VLM 以及额外推理开销。
第二,它把主观 caption 评价转化为可验证奖励。问答准确率不是完美的 caption 指标,但比“judge 给几分”更容易分析,也更难被无关套话直接攻击。
第三,它让信息密度和准确性进入同一个奖励框架。caption 要拿高分,必须包含能支持回答问题的视觉证据。论文图 2 中,CapRL 训练后的模型在图表和复杂场景描述上覆盖更充分,结构也更接近可用于问答的中间表示。
第四,它提供了可扩展的训练管线。图像收集、MCQ 生成、正反验证和 RL 优化都可以自动化。不过,可扩展不等于低成本;真正的瓶颈会转移到问题质量、筛选模型能力和训练时的额外推理。
7. 深层思考
7.1 为什么 CapRL 能够奏效?
CapRL 的核心不是“用 RL 做 caption”,而是奖励设计更贴近 caption 的功能。图像描述本质上是在把视觉信息压缩成文本。传统 judge 直接问“写得好不好”,这个问题混合了风格、长度、完整性和准确性;CapRL 问的是“这段文本能不能支持回答图像问题”,目标更窄,也更适合做奖励。
开放式生成任务很难直接评价,但封闭式验证更容易。MCQ 的答案非对即错,奖励信号比主观打分更清楚。这里的代价是,奖励只覆盖问题集问到的部分。问题没覆盖到的视觉信息,不会自然进入优化目标。
解耦也很重要。生成 caption 的 LVLM 和回答问题的纯文本 LLM 分开后,模型不能靠视觉无关的套话骗过评估器。评估器看不到图像,只能从 caption 中取证据。这使奖励更接近“信息是否被写进 caption”。
7.2 方法论的普适性
CapRL 的思路可以抽象成一句话:直接评价质量困难时,改用下游任务表现定义上游产物的质量。
| 任务 | 类比应用 |
|---|---|
| 文档摘要 | 好的摘要应能支持回答关于原文的问题 |
| 知识图谱构建 | 好的 KG 应能支持多跳推理查询 |
| 代码文档生成 | 好的文档应能帮助开发者正确使用 API |
| 数据标注 | 好的标注应能支持下游模型的准确预测 |
这个思路适合那些“生成物本身难打分,但可以通过功能性测试验证”的任务。关键是代理任务不能偏离原任务太远,否则模型会优化代理指标,而不是优化真正需要的质量。
7.3 局限性与后续问题
MCQ 覆盖会决定模型学到什么。如果问题集偏向物体识别,模型可能更关注类别、数量和位置,而忽略氛围、叙事关系或细粒度风格信息。问题生成策略本身会变成新的 inductive bias。
caption 质量也不只等于问答准确率。可读性、逻辑组织、冗余控制和语言流畅性同样重要,但这些维度未必能被 MCQ 完整捕捉。后续奖励可能需要同时约束事实覆盖和表达质量。
评估 LLM 的能力也是上限之一。纯文本 LLM 如果推理能力不足、指令遵循不稳定,奖励会带噪声;如果它能通过问题选项模式猜答案,奖励又会被污染。正反验证能缓解一部分问题,但不能完全消除。
计算开销同样不可忽视。每个 caption 要触发多道 MCQ 推理,训练成本会高于普通 SFT。实际使用时需要在问题数量、评估模型大小和奖励稳定性之间取舍。
8. 总结
CapRL 的重点在于奖励函数。它没有继续让 LVLM judge 对 caption 给一个主观分数,而是让 caption 承担中间证据的角色:纯文本 LLM 能否只根据它回答图像问题。
8.1 核心贡献
- 提出可验证 caption reward:用 MCQ 回答正确率替代主观评分,降低 Reward Hacking 风险。
- 设计 MCQ 筛选机制:通过“看图能答对、不看图答不对”的正反验证,减少常识泄露和语言线索泄露。
- 结合 GRPO 训练 VLM:让模型在 RL 中学习生成更能支持问答的 dense caption。
8.2 更广泛的启示
这项工作的价值不只在图像描述任务。它更像是 RL 奖励设计的一个实例:不要急着让模型或人类直接评价开放式文本质量,先看能否构造一个可验证代理任务。
与其直接量化主观质量,不如找到一个可验证的代理指标,让模型为可检查的功能性目标优化。
这个原则和 RLVR 的思路一致。区别在于,数学题的 reward 天然可验证,而 caption 这类任务需要人为构造验证问题。CapRL 的贡献就在这里:它给了图像描述一个相对清晰的 reward 接口,也暴露了接口本身的边界。
9. 延伸阅读
如果你对 RLHF 和奖励模型设计感兴趣,以下工作值得进一步了解:
RLAIF:Constitutional AI, Anthropic 2023:使用 AI 反馈替代人类反馈。
RLVR:DeepSeek-R1:基于可验证奖励的强化学习。
Self-Rewarding LM:Meta 2024:让模型自我评判以实现迭代改进。
本文为个人论文阅读笔记整理,如有疏漏欢迎指正。
Leave a Comment